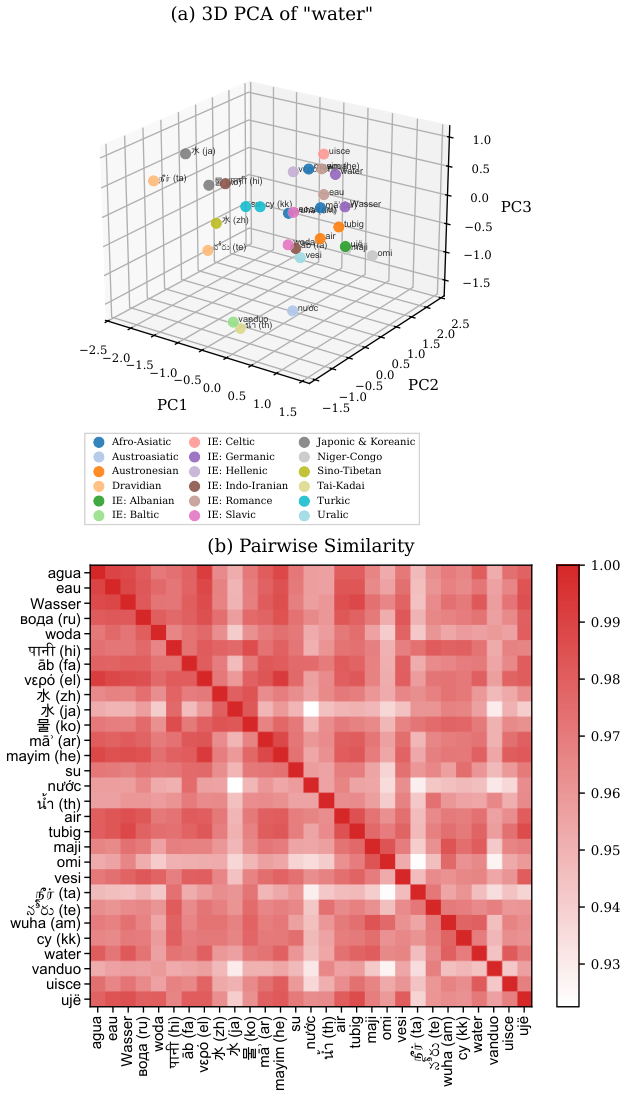
Um modelo multilíngue representa um mesmo conceito de forma parecida quando ele aparece em idiomas diferentes? Um estudo disponível no arXiv investigou essa questão examinando as representações internas do NLLB-200, modelo de tradução da Meta com 600 milhões de parâmetros. Segundo o resumo do artigo, a análise abrangeu 135 idiomas e 101 conceitos da lista Swadesh, tanto em palavras isoladas quanto em palavras inseridas em estruturas de contexto.
O efeito do idioma diminui com contexto
De acordo com os autores, a identidade do idioma respondeu por 45,7% da variação das representações quando as palavras foram analisadas isoladamente. No regime contextualizado, essa parcela foi de 13,7%. O resultado indica que, nessa análise, o contexto reduz o peso relativo associado ao idioma, mas não significa que ele desapareça.
O estudo também aplicou uma centralização das representações, chamada mean-centering. Segundo o artigo, a razão entre distâncias de conceitos distintos e semelhantes passou de 1,15 para 2,46 nas palavras isoladas e de 2,25 para 2,69 no contexto. Os autores relatam que a separação conceitual foi mais alta na camada 10 do modelo.
As categorias semânticas também aparecem
Segundo o resumo, a categoria semântica explicou 25,4% da variação na convergência dos conceitos Swadesh. O efeito foi superior a 20 vezes ao associado à ortografia ou à fonologia, cujos valores de R² ficaram em até 0,012. O artigo também informa que termos de cores básicas reproduziram a hierarquia de Berlin e Kay, com correlações entre 0,91 e 0,93.
O que os resultados permitem concluir
Os autores encontraram ainda relações entre distâncias representacionais e medidas de distância fonética entre idiomas: dentro de subfamílias, as correlações relatadas ficaram entre 0,65 e 0,67. Esses resultados descrevem padrões observados nas medidas do estudo; não demonstram, por si só, que o modelo compreenda conceitos da mesma forma que pessoas.
O resumo não identifica quais são os 135 idiomas da análise, por isso não permite confirmar se o português foi incluído. Os autores informam que disponibilizam o InterpretCognates, uma ferramenta interativa e um conjunto reproduzível para explorar os resultados.
Este texto foi produzido com apoio de inteligência artificial a partir das fontes acima e revisado segundo a nossa política editorial. Encontrou um erro? Peça uma correção.