Quando um modelo de linguagem é treinado do zero com textos que resolvem o mesmo problema matemático, algumas vezes de forma correta e outras de forma errada, qual solução ele passa a preferir? Segundo o estudo publicado no arXiv, a verdade pode aparecer como um « artefato de compressão » no treinamento. Os próprios autores, porém, afirmam que a compressão é uma motivação e não um mecanismo medido.
Por que o teste usual pode enganar
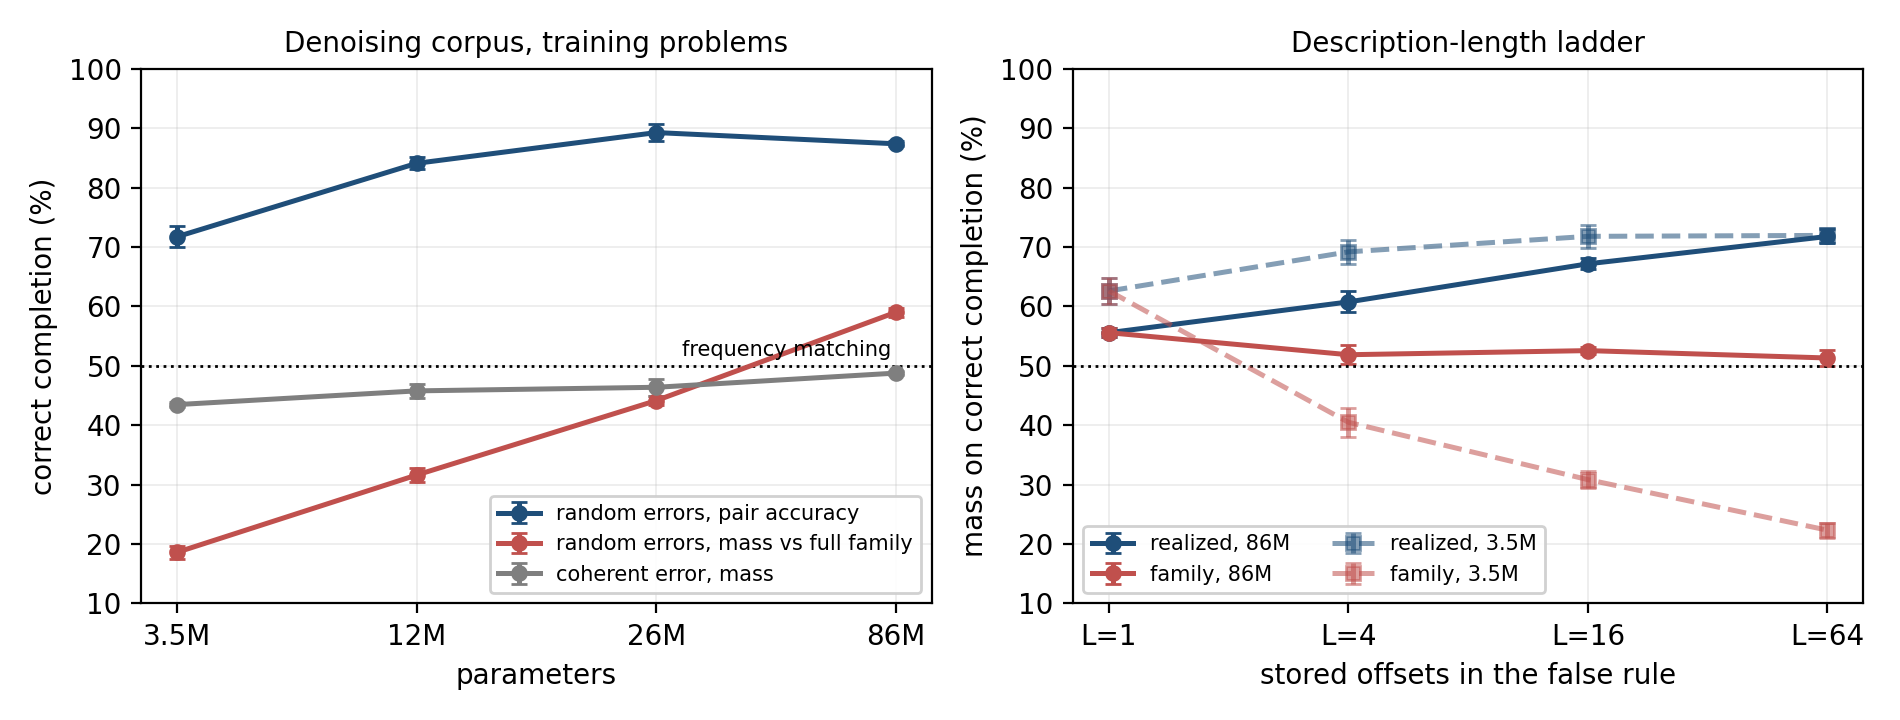
O teste mais comum compara duas completações, uma correta e uma errada, e verifica qual delas o modelo prefere. De acordo com os autores, esse método não é neutro: quando o erro pode assumir várias formas, um modelo que apenas reproduz a frequência dos dados de treino vence sem preferir nada. Por isso, eles pontuam a completação correta contra todas as strings que o gerador de erros consegue produzir. Nesse critério, a correspondência pura de frequências marca exatamente 0,500.
O que os números mostram
Com 86 milhões de parâmetros, a completação correta fica com 59,0% ± 0,8% da massa contra erros aleatórios, e com 59,4% em um corpus independente. O erro realizado único dá 77,6%, e a acurácia por pares chega a 87,4%. Segundo o estudo, as medidas de pares superestimam o excesso acima do acaso de três a quatro vezes. Abaixo de 86 milhões de parâmetros, o corpus principal não mostra preferência.
Falsidades coerentes não são filtradas
As regras falsas coerentes dos corpora principais não foram filtradas em nenhum tamanho testado, com parcelas entre 43,5% e 48,8%. Os autores explicam que a diferença abaixo de 0,5 se deve ao comprimento das completações. Em outro experimento, com as strings falsas fixas, uma regra falsa cujo seletor o modelo consegue aprender levou a parcela correta de 5 pontos acima do nulo para 7 pontos abaixo, na faixa de 418 milhões a 3,08 bilhões de parâmetros. Mesmo assim, a completação correta ainda supera a string selecionada.
A conclusão dos autores
Para o estudo, o que esses modelos deixam sem filtro é estrutura falsa consistente ou aprendível, com uma exceção de corrupção de regra única, e não a falsidade em si. Dois experimentos desenhados para identificar um mecanismo de compressão elevaram as medidas de pares enquanto a parcela somada ficou estável ou caiu. Por isso, os autores os classificam como controles negativos.
Este texto foi produzido com apoio de inteligência artificial a partir das fontes acima e revisado segundo a nossa política editorial. Encontrou um erro? Peça uma correção.