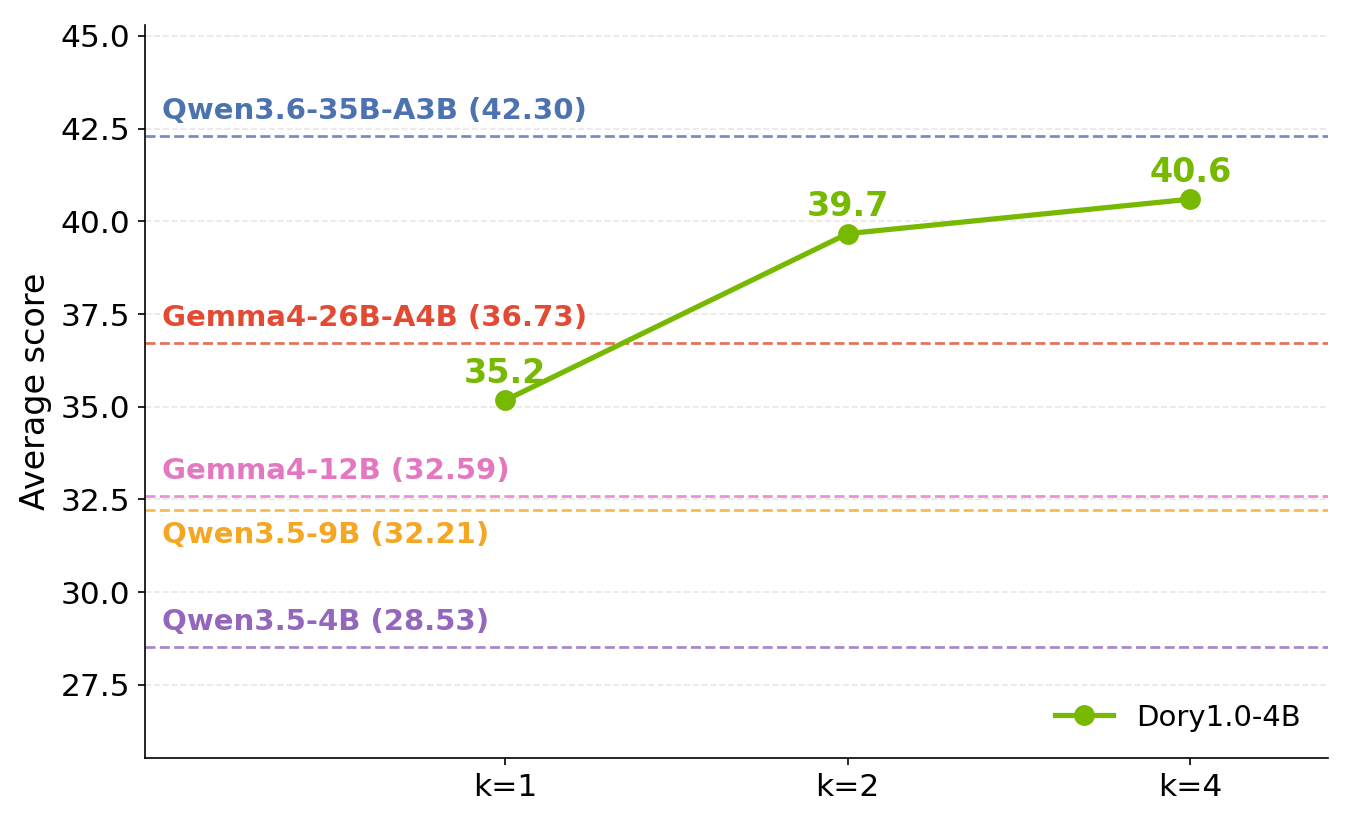
Modelos de linguagem costumam ter um tamanho fixo: cada pedido passa pelas mesmas camadas, do mesmo jeito. O Dory1.0-4B, apresentado em um artigo no arXiv, tenta mudar isso. Segundo os autores, ele é um modelo de linguagem de 4 bilhões de parâmetros com profundidade elástica: um único checkpoint atende a diferentes orçamentos de computação na hora de gerar respostas.
Como funciona o loop
De acordo com o resumo, a arquitetura é dividida em três partes: um bloco de entrada, um bloco recorrente compartilhado e um bloco de saída. Na inferência, o bloco recorrente pode ser aplicado um número variável de vezes. Os autores também descrevem um treinamento pós-treino com uma "curricula de loops" sensível à dificuldade, que direciona prompts mais difíceis para mais loops.
O que os autores relatam
Segundo o artigo, aumentar o número de loops melhora a precisão, com os maiores ganhos em benchmarks de código, agênticos e de contexto longo. Com dois ou mais loops, o modelo supera, em média nos 12 benchmarks avaliados, modelos maiores citados pelos autores: Qwen3.5-9B, Gemma 4 12B e Gemma 4 26B-A4B.
Há ainda um dado sobre eficiência: em benchmarks agênticos, com quatro loops, o modelo gera de 1,3 a 2,5 vezes menos tokens do que com um loop. Os autores explicam que o cálculo extra acontece no espaço latente, em vez de produzir saídas mais longas.
Memória e formatos abertos
Para reduzir o uso de memória, o Dory1.0-4B guarda chaves e valores do cache apenas do último loop. Segundo o artigo, isso mantém a pegada de memória do cache igual à de um modelo sem loops, qualquer que seja o número de loops, e preserva a maior parte dos ganhos de precisão.
Os autores também informam que disponibilizam os checkpoints nos formatos BF16, MXFP8, NVFP4 e GGUF quantizado.
Vale notar um ponto importante: o resumo não traz requisitos de hardware nem medições em equipamentos modestos, então a utilidade para quem roda IA com pouca memória ainda depende de testes que o próprio artigo, pelo resumo, não apresenta.
Este texto foi produzido com apoio de inteligência artificial a partir das fontes acima e revisado segundo a nossa política editorial. Encontrou um erro? Peça uma correção.