Agentes de IA que executam tarefas em várias etapas costumam ser treinados com aprendizado por reforço multi-turno. Um estudo publicado no arXiv questiona até onde essa técnica realmente melhora o desempenho. Segundo os autores, os ganhos dependem fortemente das restrições de interação, e não apenas do algoritmo usado.
O que o estudo mediu
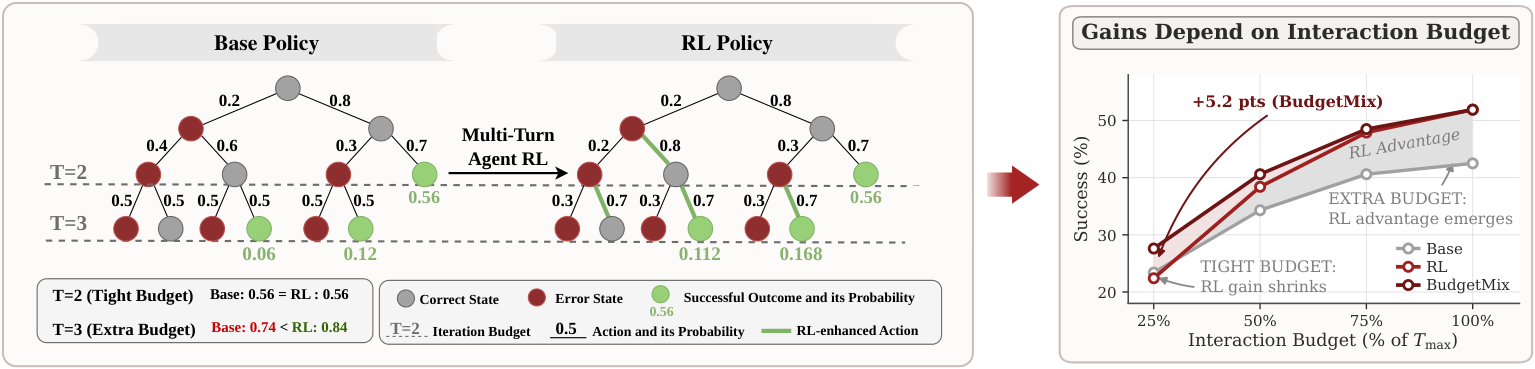
A avaliação combina duas variáveis: a amplitude de amostragem K e a profundidade de interação T. Os autores as reúnem na métrica Pass@(K,T). Com ela, mostram que as vantagens do RL em nível de trajetória dependem de orçamentos suficientes de turnos. Quando esse orçamento diminui, os ganhos caem de forma significativa.
Onde o ganho aparece
Outro achado é que o aprendizado por reforço agêntico não melhora de maneira uniforme a qualidade de cada decisão isolada. De acordo com o resumo, sua força se concentra na recuperação de erros e na resiliência em tarefas de longo prazo. Isso muda a leitura de resultados que apontam melhora geral: parte do benefício pode estar em se recuperar de falhas, e não em decidir melhor a cada passo.
A proposta para reduzir o risco
Para lidar com essa dependência do orçamento, os autores fazem uma discussão preliminar sobre sinais de supervisão de processo, apontando benefícios e limitações. Eles também apresentam o BudgetMix RL, um método que varia os orçamentos de interação durante o treinamento. Segundo o resumo, os experimentos mostram desempenho robusto em diferentes condições de execução.