Preferências de cookies

Escolha o que podemos usar. Cookies não essenciais só são ativados com a sua permissão. Detalhes na política de cookies.

Categorias de cookies

Detectores de texto de IA perdem precisão em temas específicos, aponta estudo

Por · Publicado em · 1 fonte citada

Em resumo

  • Um preprint no arXiv analisa detectores baseados em Transformers e identifica três padrões que enganam esses sistemas, como a confusão de textos formais humanos com texto de IA.
  • Segundo os autores, métodos puramente estatísticos têm limites em domínios muito estruturados.
  • Detectores que tentam separar texto escrito por pessoas de texto gerado por modelos de linguagem podem falhar quando o assunto muda.
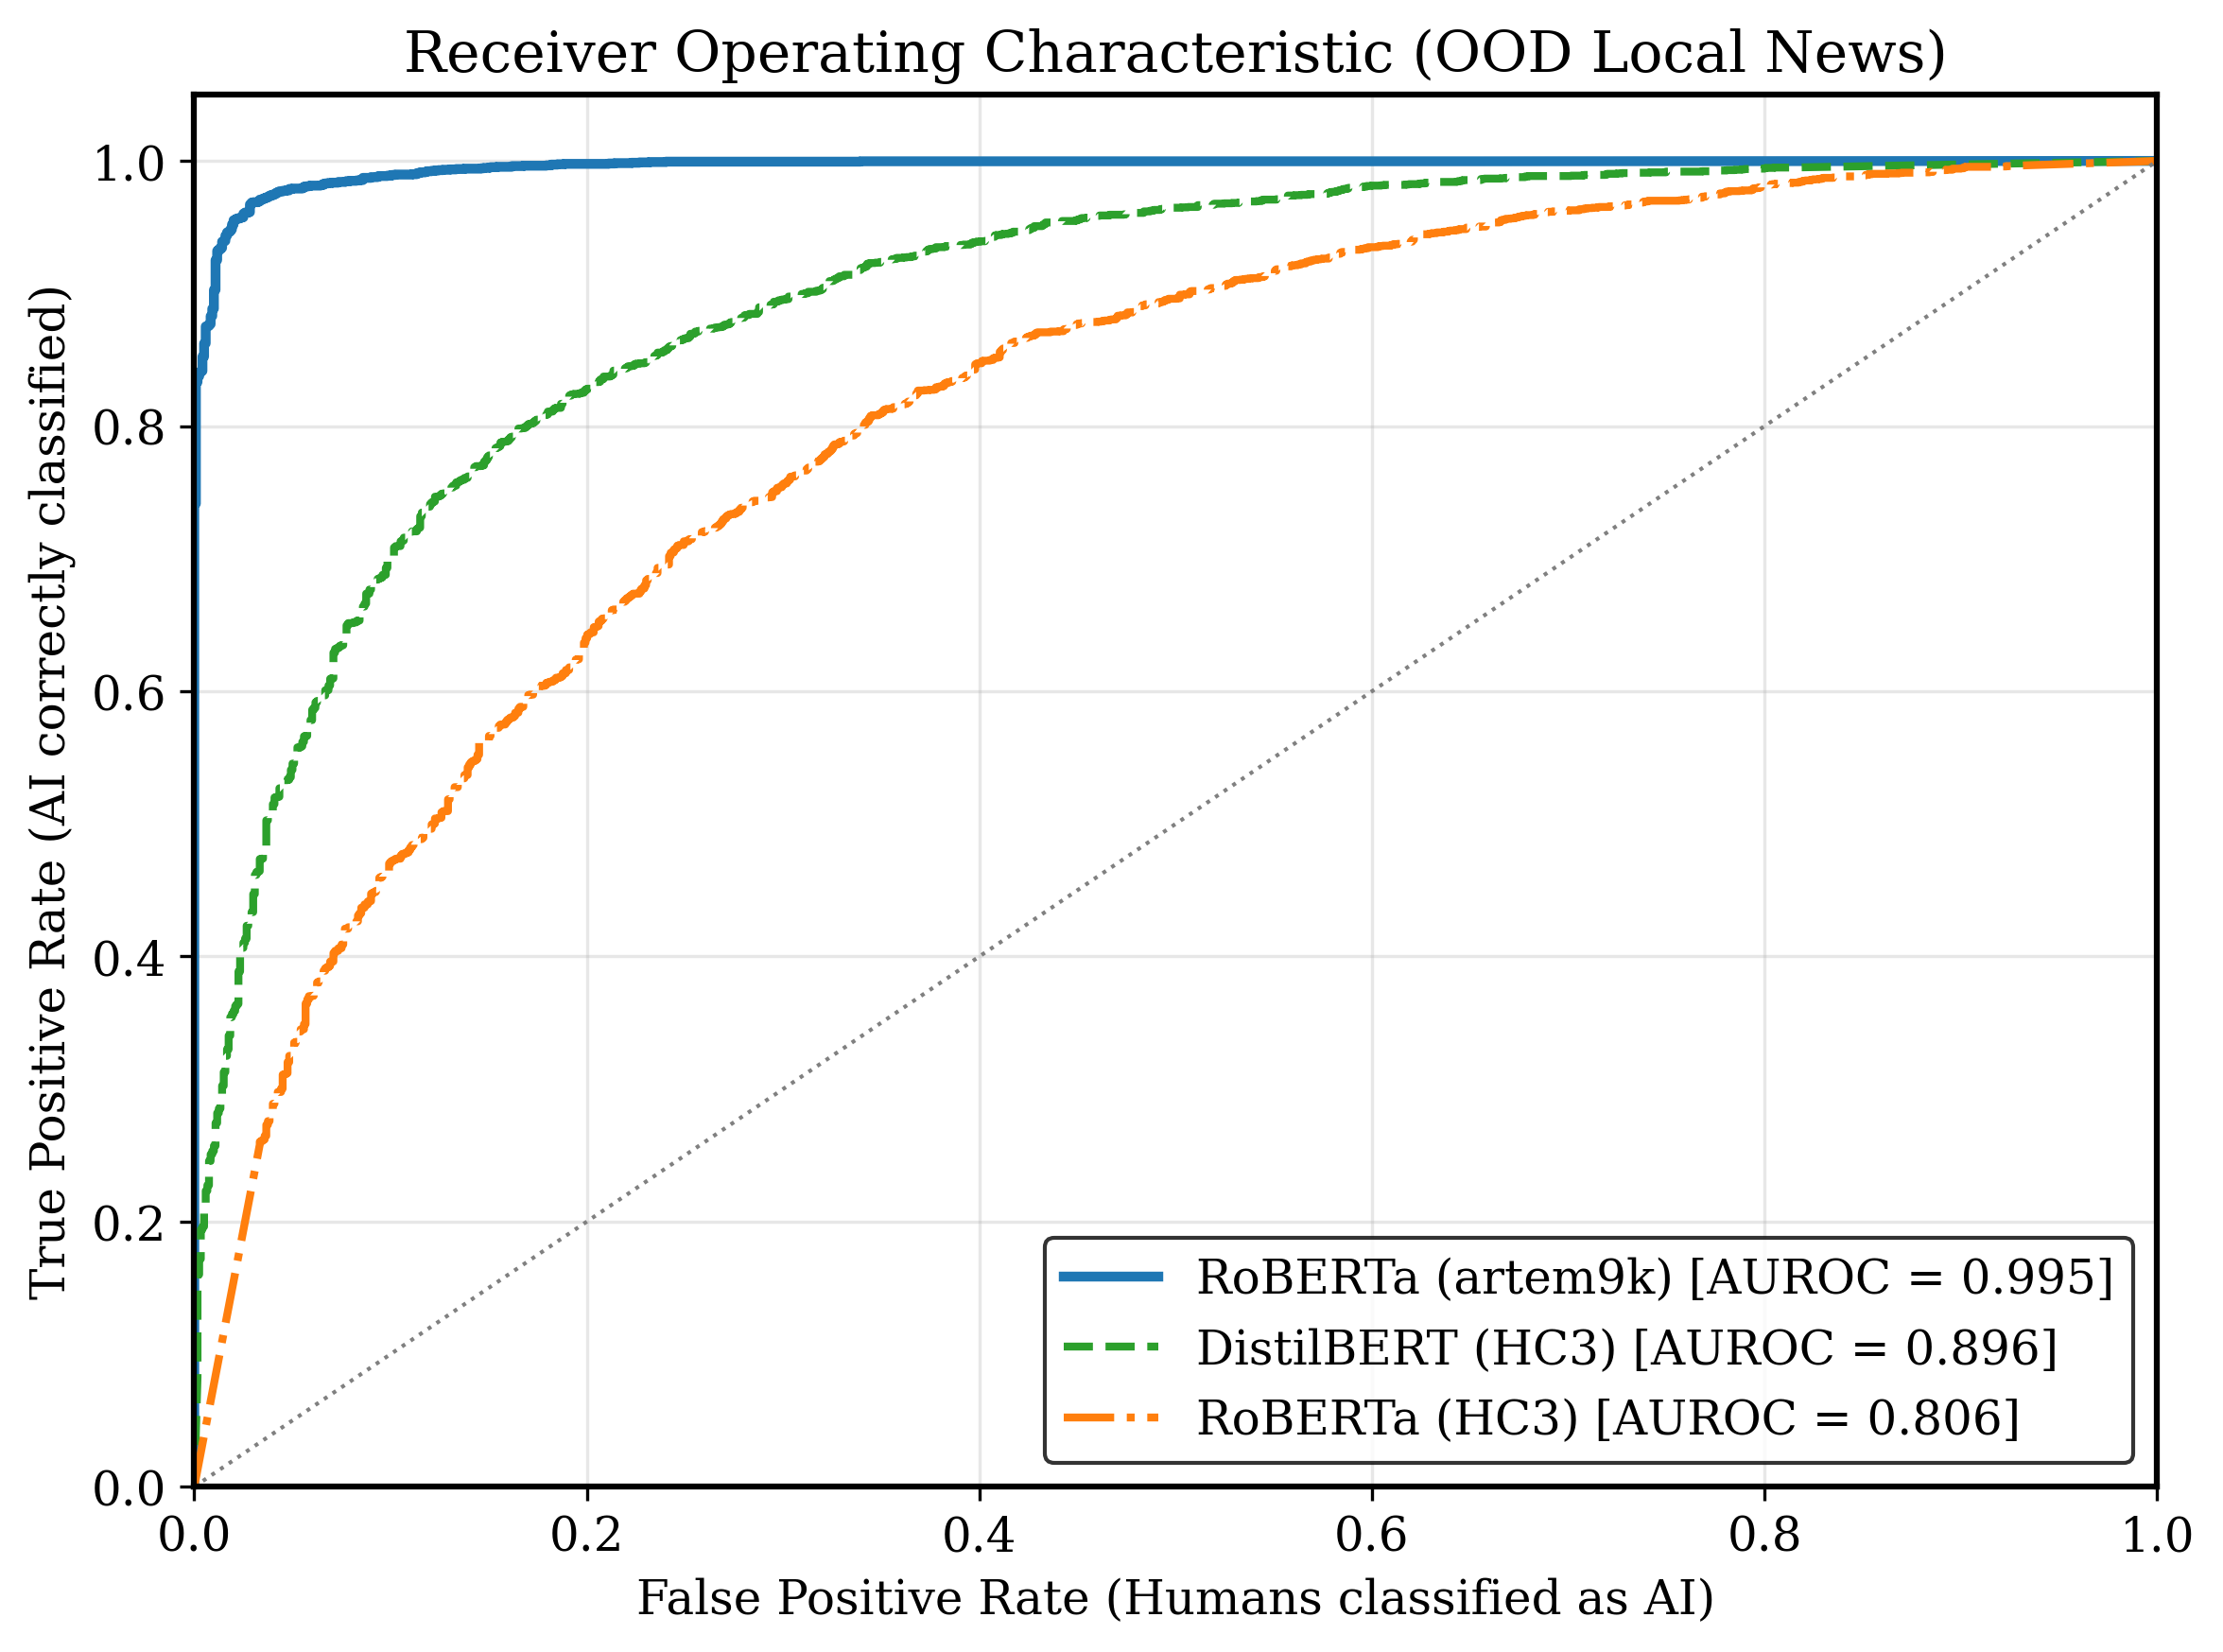
Fig. 1 : Receiver Operating Characteristic (ROC) curves for the evaluated models on the hyper-local OOD dataset. The curves demonstrate that while RoBERTa (artem9k) achieves excellent class separation, its default 0.5 threshold is severely
Figura do estudo “Specificity Bias and the Wikipedia Paradox: An xAI Analysis of AI Text Detectors under Domain Shift”, de Nico Morloher e outros (arXiv) · CC BY 4.0

Detectores que tentam separar texto escrito por pessoas de texto gerado por modelos de linguagem podem falhar quando o assunto muda. É o que sugere um estudo publicado no arXiv, ainda em versão preliminar (v1), que avalia modelos como DistilBERT e RoBERTa em notícias hiperlocais geradas por LLMs de código aberto (Llama 3, Mistral e Gemma). Segundo o resumo, os autores usaram uma abordagem de IA explicável baseada em SHAP para entender por que os classificadores decidem como decidem.

Os três padrões identificados

De acordo com o resumo, o estudo aponta três fenômenos:

  • Síndrome da chamada à ação: os detectores se apoiariam em traços típicos de LLMs ajustados para seguir instruções, e não em características gerais de textos de máquina.
  • Viés de especificidade: os modelos conseguiriam burlar a detecção ao inventar entidades nomeadas específicas (nomes de pessoas, lugares ou organizações) e imitar imperfeições de uma conversa.
  • Paradoxo da Wikipédia: textos humanos formais e objetivos seriam classificados como IA por causa de sua baixa «burstiness» estatística, termo que o resumo usa sem detalhar.

O que muda para quem usa esses detectores

A conclusão dos autores é que detecção puramente estatística enfrenta limitações sistemáticas em domínios muito estruturados e que seria necessário criar arquiteturas semanticamente conscientes e interpretáveis. Na prática, isso sugere que um texto escrito por pessoa, mas em estilo formal, pode ser sinalizado de forma injusta, o que preocupa em contextos de avaliação.

O resumo, porém, não trata de escolas, provas ou revisões editoriais, então qualquer aplicação nesses cenários é uma extrapolação. Também não informa métricas de acurácia, tamanho do conjunto de dados nem como ele foi montado além do que está descrito acima. Vale a leitura do artigo completo antes de tirar conclusões operacionais.

Fontes

  1. Specificity Bias and the Wikipedia Paradox: An xAI Analysis of AI Text Detectors under Domain Shift (arXiv:2611.03280v1)

Este texto foi produzido com apoio de inteligência artificial a partir das fontes acima e revisado segundo a nossa política editorial. Encontrou um erro? Peça uma correção.

Leia também