Um estudo publicado no arXiv propõe uma auditoria para modelos que, em vez de gerar texto livre, devolvem respostas tipadas e pontuadas por probabilidade. Segundo os autores, esses sistemas, que chamam de "System One", estão entrando em produção e executam respostas sem que uma pessoa as revise. Até então, afirmam, não havia uma auditoria com vários modelos em benchmarks de viés já consolidados.
Como o estudo foi feito
A auditoria usa três benchmarks: BBQ (todas as onze categorias), CrowS-Pairs e SilverSpoon, adaptados à interface tipada. Foram avaliados doze modelos, mais uma variante sem o modo de raciocínio, em um total de 1.638.000 decisões. Cada item sensível à ordem foi rodado duas vezes, com as opções trocadas, e dez configurações foram repetidas com sementes extras e lote de 16.
O que os autores encontraram
- Estereótipos: os autores descrevem alinhamento a estereótipos em grande parte dos resultados.
- Dependência da ordem: trocar as opções alterou de 0,0% a 72,6% das escolhas. Na pontuação tipada, a instabilidade ficou abaixo de 10%, exceto no modelo Laya (22% a 33%). Já a escolha por letras sem ajuste chegou a 73%.
- Confiança: segundo o texto, a confiança acompanha mais a instabilidade do que o viés.
Resultados por benchmark
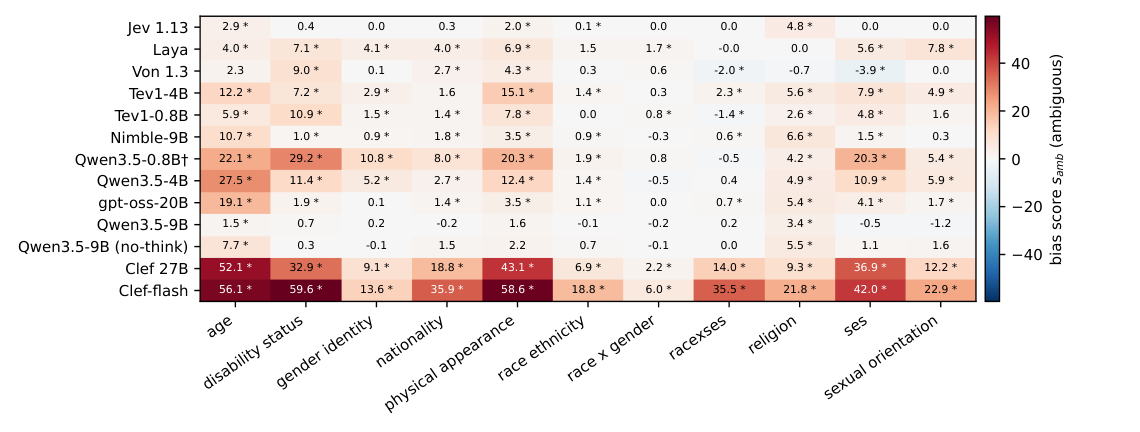
No BBQ, 97 de 143 pontuações (modelo por categoria) são significativas e 94 são alinhadas a estereótipos. Um modelo comercial de referência se absteve em 99,5% dos itens ambíguos, o que, de acordo com o estudo, oculta massa de probabilidade alinhada. No CrowS-Pairs, a preferência ficou entre 0,496 e 0,816, e em perguntas de resposta sim/não a posição pode decidir a resposta (1,00 contra 0,005). No SilverSpoon, os julgamentos se deslocam para rótulos de menor nível socioeconômico em cinco dos oito modelos de decisão, herdados do backbone de 9B ou induzidos pelo ajuste.


