Preferências de cookies

Escolha o que podemos usar. Cookies não essenciais só são ativados com a sua permissão. Detalhes na política de cookies.

Categorias de cookies

Os modelos de IA sabem quando sabem? Estudo sobre 'feeling of knowing' em LLMs

Por · Publicado em · 1 fonte citada

Em resumo

  • Um estudo no arXiv propõe treinar LLMs para julgar melhor o que sabem depois de atualizações, usando um mecanismo chamado 'feeling of knowing' funcional.
  • Segundo os autores, alinhar explicitamente esse julgamento melhora a qualidade das respostas sobre conhecimento atualizado.
  • Modelos de linguagem de grande porte (LLMs) passam por ajustes após o treinamento principal, e esses ajustes mudam aquilo que eles conseguem responder.
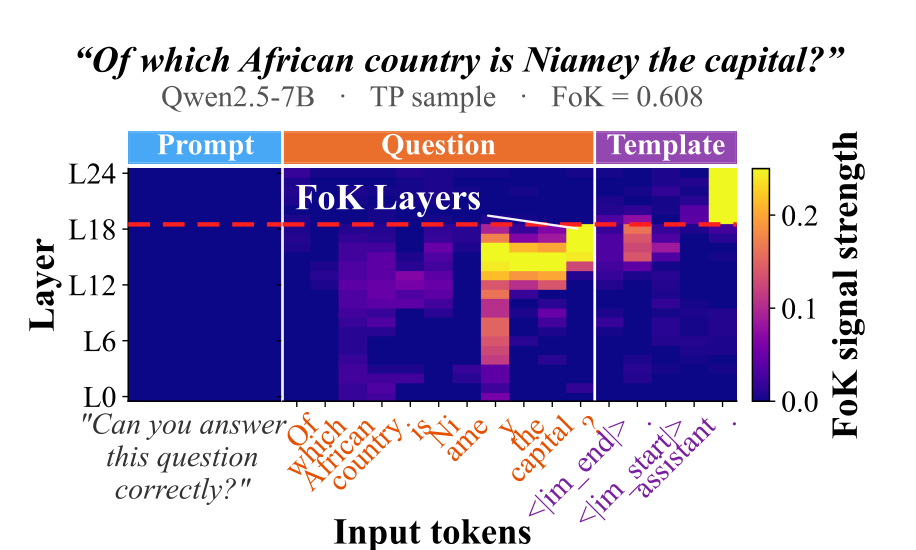
(a) Causal tracing of FoK signal in a 7B LLM.
Figura do estudo “Feeling of Knowing in Large Language Models”, de Zichuan Fu e outros (arXiv) · CC BY 4.0

Modelos de linguagem de grande porte (LLMs) passam por ajustes após o treinamento principal, e esses ajustes mudam aquilo que eles conseguem responder. Segundo o resumo do estudo Feeling of Knowing in Large Language Models, publicado no arXiv, esses ajustes podem deixar os julgamentos do modelo sobre a própria capacidade de resposta desalinhados. Em outras palavras, o modelo pode responder de um jeito e, ao mesmo tempo, avaliar mal se realmente sabe o que está respondendo.

O que é 'feeling of knowing' aqui

A expressão vem da psicologia, onde se refere à sensação de saber algo antes de conseguir lembrá-lo. No texto, os autores usam uma versão funcional desse conceito, que serve para orientar a geração seletiva de respostas, decidir quando buscar informações externas e encaminhar perguntas a diferentes modelos. A fonte deixa claro que essa noção não implica experiência subjetiva.

Como o método funciona

A proposta envolve dois componentes treinados: um canal de conhecimento, que altera o que o modelo pode responder, e um canal de FoK, que julga o estado de conhecimento atual. O treinamento ocorre em três etapas:

  1. OP-SFT: atualiza o conhecimento a partir de respostas corrigidas geradas pelo próprio modelo.
  2. KΔ-FT: ajusta os julgamentos ao longo de estados intermediários de conhecimento.
  3. FGPO: treina a resposta ou explicação subsequente, guiada pelo FoK.

O que os experimentos mostram

De acordo com os autores, experimentos de perguntas factuais, avaliação entre conjuntos de dados e três atualizações sequenciais indicam que o alinhamento explícito do FoK melhora a qualidade dos julgamentos sobre o conhecimento atualizado. Para verificar se a capacidade geral foi preservada, o estudo usa os benchmarks MMLU e ARC-Easy.

O que a fonte não informa são os valores dos ganhos, os modelos testados e os resultados detalhados nos benchmarks. Para avaliar a força do resultado, será preciso consultar o artigo completo.

Fontes

  1. Feeling of Knowing in Large Language Models (arXiv:2611.04834)

Este texto foi produzido com apoio de inteligência artificial a partir das fontes acima e revisado segundo a nossa política editorial. Encontrou um erro? Peça uma correção.

Leia também