Modelos de linguagem conseguem aprender uma tarefa apenas com exemplos colocados no próprio prompt, sem que seus parâmetros sejam atualizados. Essa capacidade se chama aprendizado em contexto (in-context learning, ou ICL). Segundo o artigo A Circuit for In-Context Learning, publicado no arXiv, um estudo descreve agora o circuito interno que faz isso acontecer em uma tarefa de classificação de frases com rótulos arbitrários.
Por que isso é difícil de explicar
Quando os rótulos são arbitrários, o modelo não pode ter memorizado a correspondência entre entrada e rótulo. Por isso, segundo a fonte, o aprendizado acontece dentro de um único passe de processamento (forward pass). Trabalhos anteriores já tinham encontrado partes candidatas, mas não como elas se combinam. É isso que o novo estudo propõe.
As peças do circuito
De acordo com o resumo, o modelo funciona como uma memória do tipo chave-valor sobre as posições dos tokens de rótulo:
- Tokens de rótulo: o estado interno de cada token de rótulo codifica a identidade do rótulo.
- Cabeças de atenção de camadas intermediárias: escrevem nesse token a classe do exemplo anterior, usada como chave.
- Cabeças de camadas superiores: na pergunta, comparam a classe da consulta com as chaves armazenadas e copiam o rótulo correspondente.
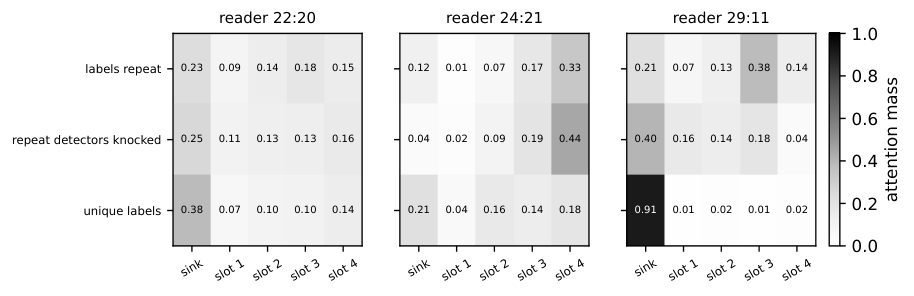
- Sinal de camadas iniciais: indica se algum rótulo se repetiu e controla essa leitura. Sem ele, as cabeças de leitura prestam atenção no início do prompt e nenhum rótulo é favorecido.
- Supressão: um conjunto separado de cabeças suprime o rótulo visto por último.
Como os autores chegaram a essa conclusão
Segundo a fonte, cada etapa foi testada de forma causal, com activation patching, ablação de cabeças comparada a cabeças aleatórias e direcionamento (steering) usando os próprios sinais do modelo. Um modelo softmax simples da leitura, com duas constantes por cabeça, ajustado em uma distribuição de prompts, previu o comportamento em outra distribuição.
Até onde os resultados vão
O resumo afirma que a computação se conserva em três modelos de 3 a 4 bilhões de parâmetros, que as cabeças nomeadas reproduzem sozinhas o comportamento e que um transformer treinado do zero desenvolve as mesmas partes. Também diz que o circuito se estende a conceitos semânticos e a rótulos com significado, e que aparece em modelos de 0,6 a 8 bilhões de parâmetros de uma mesma família, sobrevivendo ao ajuste por instruções.
Em termos práticos, a conclusão do estudo é que o ICL, nesse cenário, funciona como uma busca associativa com portão, montada a partir de poucos tipos de componentes identificáveis. A fonte disponível é apenas o resumo, por isso não há detalhes sobre os experimentos completos nem sobre outras tarefas além da classificação de frases.
Este texto foi produzido com apoio de inteligência artificial a partir das fontes acima e revisado segundo a nossa política editorial. Encontrou um erro? Peça uma correção.